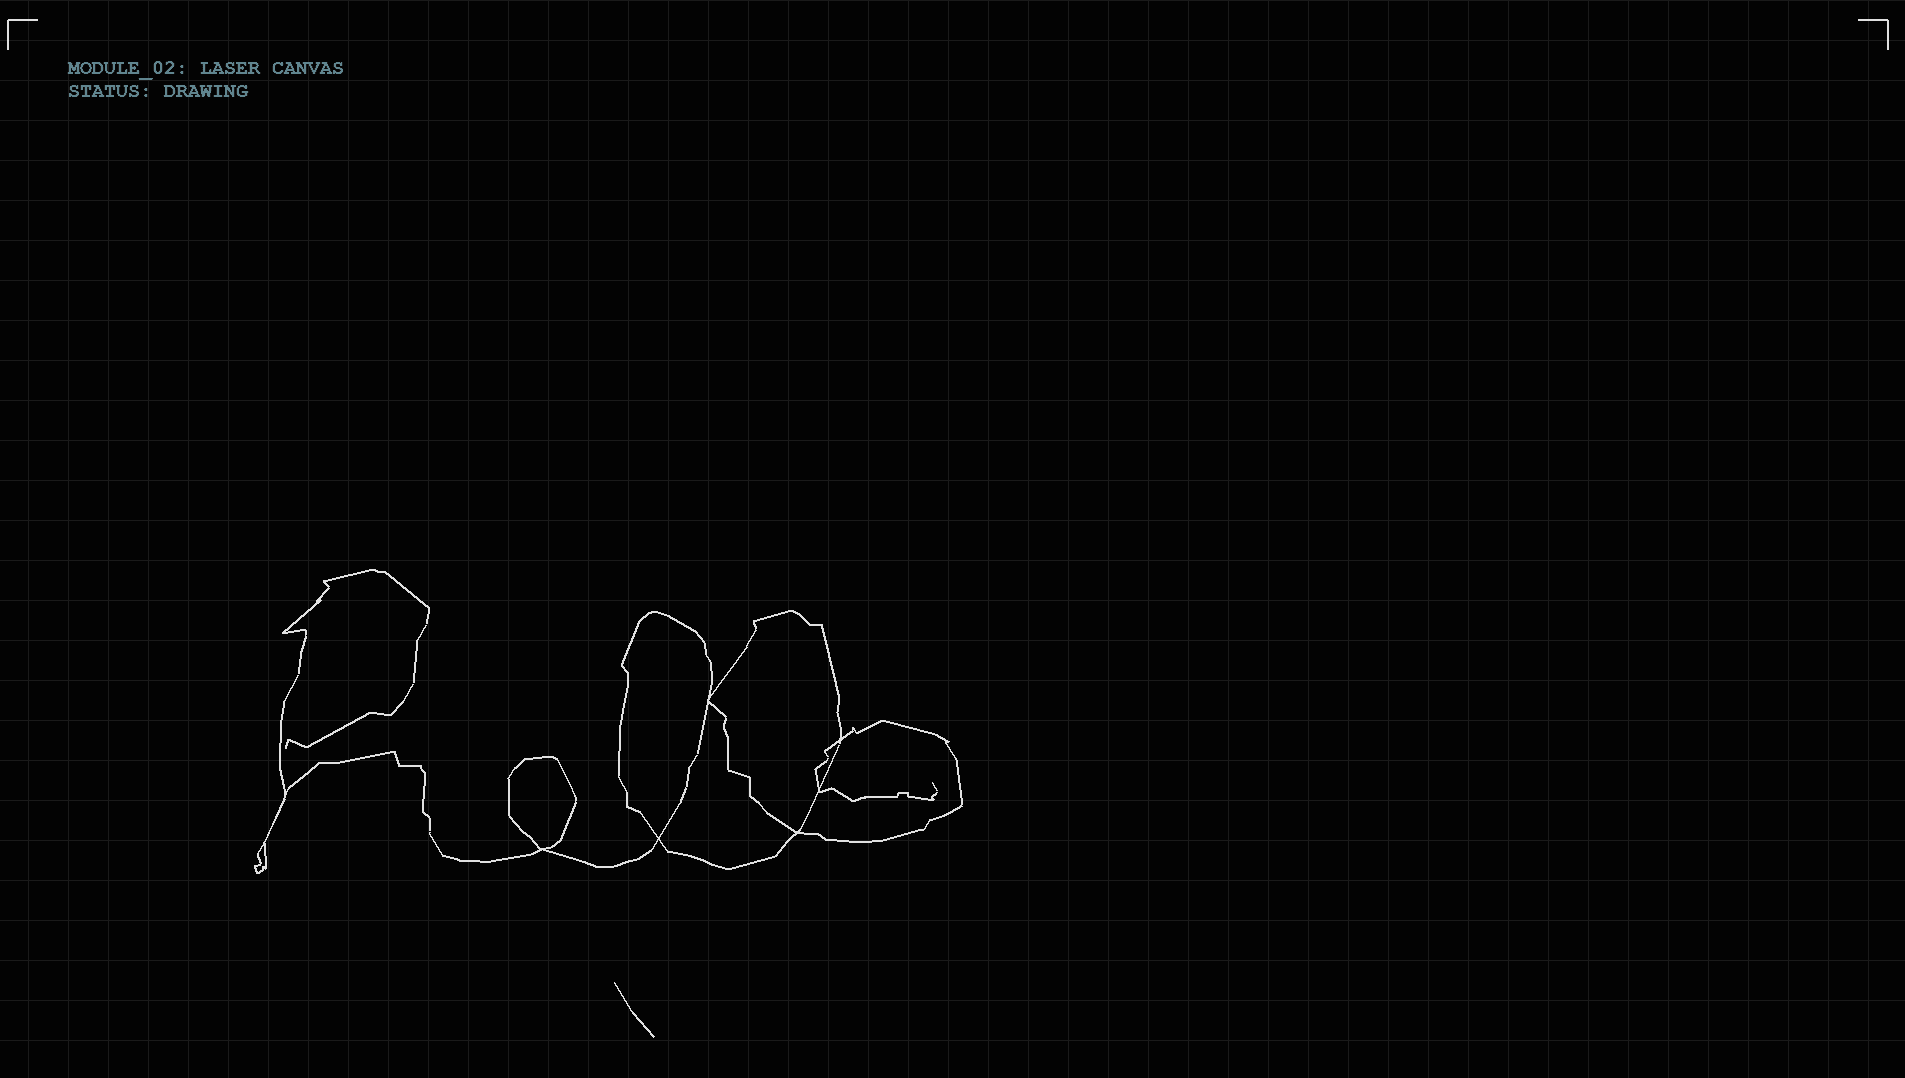Le cœur du système repose sur une boucle principale cadencée à 30 ms qui traite les flux de la webcam et extrait en direct les 21 points anatomiques clés de la main grâce à MediaPipe. Pour remplacer la souris et le clavier, j'ai modélisé une grammaire gestuelle complète : l'index pointé guide le curseur avec amortissement cinétique pour stabiliser la visée, le pincement (pinch) gère le clic ou le tracé continu en mode dessin, la paume ouverte commande le zoom dynamique, tandis que le poing fermé agit comme une commande de secours pour revenir instantanément au hub central.
Les modules 3D — du nuage de 100 cubes filaires (Neural Matrix) au puzzle volumique (Assembly) — ne reposent sur aucun moteur de jeu tiers : toutes les projections perspectives et rotations sont calculées dynamiquement à la volée via des matrices NumPy. Dans le mode d'assemblage, l'utilisateur manipule cinq composants géométriques distincts (processeur, mémoires, liaisons synaptiques) dotés d'un algorithme de magnétisme (snap automatique), déclenchant des ondes de choc, des flux d'énergie lumineux et des gerbes de particules dès qu'une connexion spatiale est validée.
Afin de renforcer la dimension professionnelle et immersive du dispositif, j'ai implémenté une gestion matérielle multi-écrans via la bibliothèque screeninfo. Le système détecte automatiquement la présence d'un affichage secondaire : si deux moniteurs sont branchés, le tableau de bord de télémétrie et de contrôle reste ancré sur l'écran principal, tandis que les espaces interactifs (scènes 3D, canvas laser, zone d'assemblage) basculent automatiquement en mode plein écran sans bordure sur le second moniteur, offrant une surface d'interaction dégagée et immersive.
En parallèle, un thread audio tourne en continu en tâche de fond pour écouter les ordres de l'utilisateur via reconnaissance vocale. Dès que le mot-clé d'activation « Jarvis » est prononcé, le système analyse la requête : il pilote directement l'OS pour changer d'espace de travail ou transmet la consigne au modèle open-source Llama 3:8B, hébergé en local via Ollama. La réponse générée est retranscrite dans le journal de bord de l'interface et oralisée instantanément par un moteur de synthèse vocale asynchrone, concrétisant une interaction humain-machine multimodale fluide et totalement autonome.